在构建我的 AI Generative UI博客时,我遇到了一个经典难题:搜索。
传统的 SQL LIKE %关键词% 搜索非常“笨”。
- 用户搜:“怎么让网页变快?”
- 文章标题:《Next.js 性能优化实战》
- 结果:搜不到。因为没有字面匹配。
业界的标准解法是 RAG(检索增强生成):引入向量数据库(Vector DB),做 Embedding,搞余弦相似度计算。
但对于一个刚开始创建个人博客,引入一套全新的向量基础设施,是否属于过度设计?
在权衡了成本与效果后,我探索出了一条“降维打击”的技术路径:利用 DeepSeek 的强大语义理解能力 + MySQL 的简单查询,实现了 90% 的向量检索体验,而成本几乎为零。
本文将分享这一方案的具体实现,以及如何通过“搜索日志”构建内容生产的闭环。
核心思路:AI 意图提取 (Query Expansion)
向量检索的本质是将“语义”映射到坐标系。但 LLM 本身就是一个最强的语义处理器。
我们不需要把数据库里的文章变成向量,我们只需要把用户的问题“翻译”成数据库能听懂的关键词。
流程对比:
传统搜索:用户输入 -> 直接丢给 SQL -> 查不到。 我的方案:用户输入 -> DeepSeek 思考并提取核心技术词 -> 丢给 SQL -> 命中!
比如:
用户问:“我想学怎么部署网站”
AI 提取:“Docker Nginx 部署 上线” SQL 查询:... WHERE title LIKE '%Docker%' OR title LIKE '%部署%' ...
技术实现 (Next.js + Vercel AI SDK)
第一步:定义 AI 工具 (The Brain)
利用 Vercel AI SDK 的 tool 定义,赋予 AI “查询文章”的能力。
最关键的是 parameters 中的 Prompt 设计,我限制了关键词的数量,防止 AI 过于发散。
// ... streamText 配置中
tools: {
  getArticles: tool({
    description: '查询或推荐技术博客文章',
    parameters: z.object({
      // ✨ 核心魔法:Prompt Engineering
      keywords: z.string().describe('将用户的问题转换为 1-2 个最核心的技术关键词,用空格分隔。例如把"怎么让网站不卡"转换为"性能优化 渲染原理"'),
    }),
    execute: async ({ keywords }) => {
      console.log(`🤖 AI 提取的搜索词: ${keywords}`);

      // 1. 调用数据库查询
      const articles = await searchArticles(keywords);

      // 2. (重要) 记录搜索日志,具体见下文
      await logSearch(keywords, articles.length);

      if (!articles.length) return { message: '暂无相关文章' };

      // 3. 只返回 AI 需要的字段(节省 Token)
      return articles.map(a => ({
        title: a.title,
        summary: a.summary,
        date: a.created_at
      }));
    },
  }),
}
第二步:数据库查询 (The Muscle)
不需要复杂的全文检索引擎,简单的 SQL OR 查询配合 AI 提取的精准关键词,效果出奇的好。
'use server';
import pool from '@/lib/db';

export async function searchArticles(keywords: string) {
  // 将空格分隔的关键词拆分
  const keywordList = keywords.split(' ').filter(k => k.trim());

  if (keywordList.length === 0) return [];

  // 动态拼接 SQL: title LIKE %A% OR title LIKE %B%
  // 也可以加上 summary 字段的匹配
  const conditions = keywordList.map(() => `(title LIKE ? OR summary LIKE ?)`).join(' OR ');
  const params = keywordList.flatMap(k => [`%${k}%`, `%${k}%`]);

  const sql = `
    SELECT id, title, slug, summary, created_at
    FROM articles
    WHERE ${conditions}
    ORDER BY created_at DESC
    LIMIT 5
  `;

  const [rows] = await pool.query(sql, params);
  return JSON.parse(JSON.stringify(rows));
}
第三步:数据闭环——搜索日志 (The Insight)
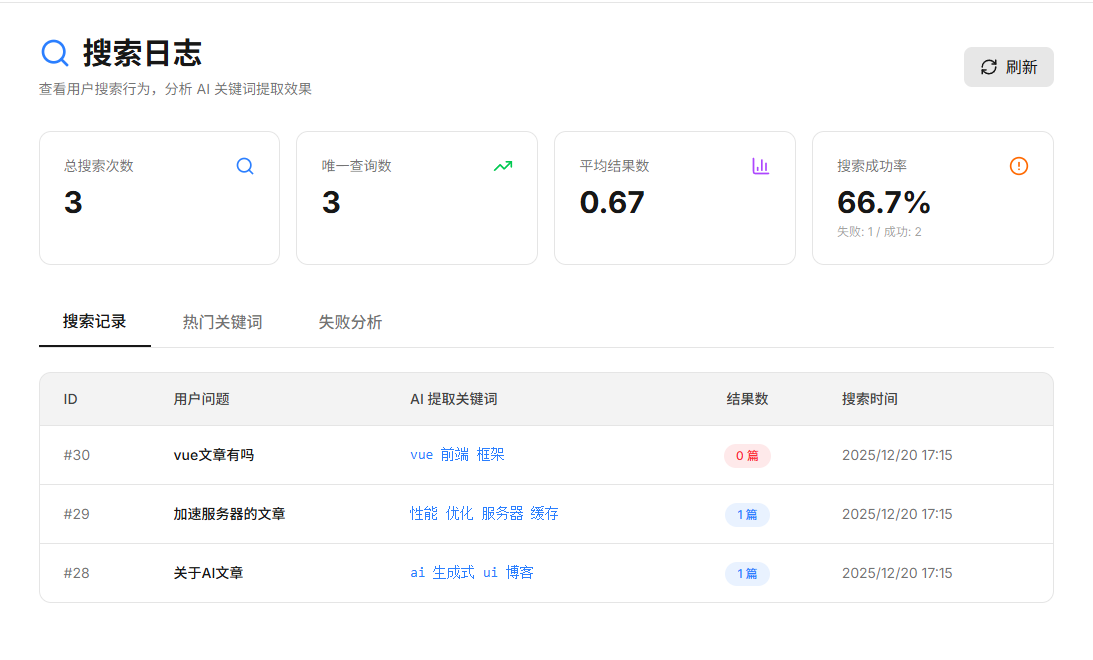
这是整个系统中最具运营价值的一环。既然所有搜索都经过 AI 提取,那么记录这些关键词,我就能知道用户真正关心什么。
CREATE TABLE `search_logs` (
  `id` INT AUTO_INCREMENT PRIMARY KEY,
  `keywords` VARCHAR(255) NOT NULL,
  `result_count` INT DEFAULT 0, -- 搜到了几篇?
  `created_at` TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
埋点逻辑:
在 AI 执行工具时,顺手记录一下。如果 result_count 为 0,说明这是用户的痛点,也就是我下一篇文章的选题。
export async function logSearch(keywords: string, count: number) {
  // Fire-and-forget,不阻塞主线程
  const sql = 'INSERT INTO search_logs (keywords, result_count) VALUES (?, ?)';
  pool.query(sql, [keywords, count]).catch(err => console.error(err));
}
效果演示
我们通过在聊天窗口发送搜索文章,AI搜索如果如下:
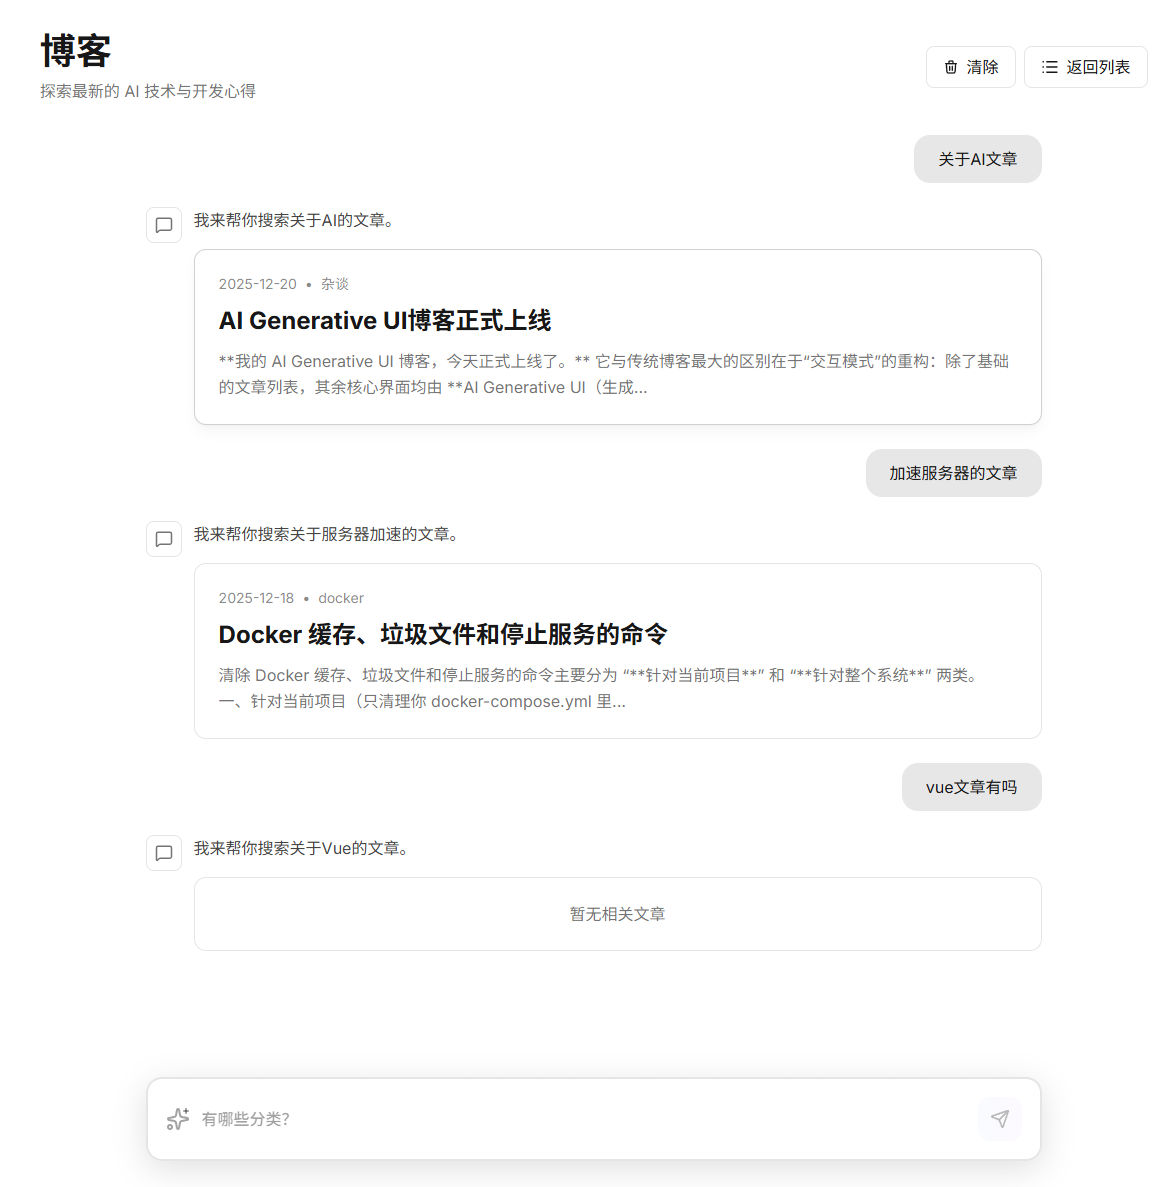
同时后台也能监测到所有数据
现在的体验是这样的:
- 用户在博客首页问:“有没有关于 TypeScript 的高级教程?”
- DeepSeek 提取关键词:TypeScript 泛型 工具类型
- 后端 SQL 查询匹配文章。
- 前端利用 Generative UI 直接弹出文章卡片(而不是文本列表)。
总结
在 AI 时代,我们容易陷入“唯技术论”,觉得不用 Vector DB 就不够 AI。
但工程化的本质是Trade-off(权衡)。
通过DeepSeek (意图理解) + MySQL (可靠存储) 的组合,我用最简的架构实现了:
1.语义级搜索体验(解决了 SQL 僵化问题)。 2.零额外成本(无需向量库费用)。 3.数据驱动运营(通过日志发现内容缺口)。
这就是独立开发者的生存之道:用最简单的技术,解决最核心的问题。